フィジカルAIとは、単に1つのモデルを高速に実行することではありません。知覚、理解、検索、推論、計画、行動、検証を繰り返す継続的なループであり、ニューラル推論に加え、センサー処理、制御フロー、アプリケーションロジック、安全監視など、さまざまな処理が組み合わされています。これらのワークロードは並行して実行され、処理パターンも不規則で、レイテンシにも高い要求が求められます。モデル単体のピークスループットだけに最適化されたプラットフォームでは、それ以外の処理がボトルネックとなり、システム全体の性能を十分に引き出すことができません。
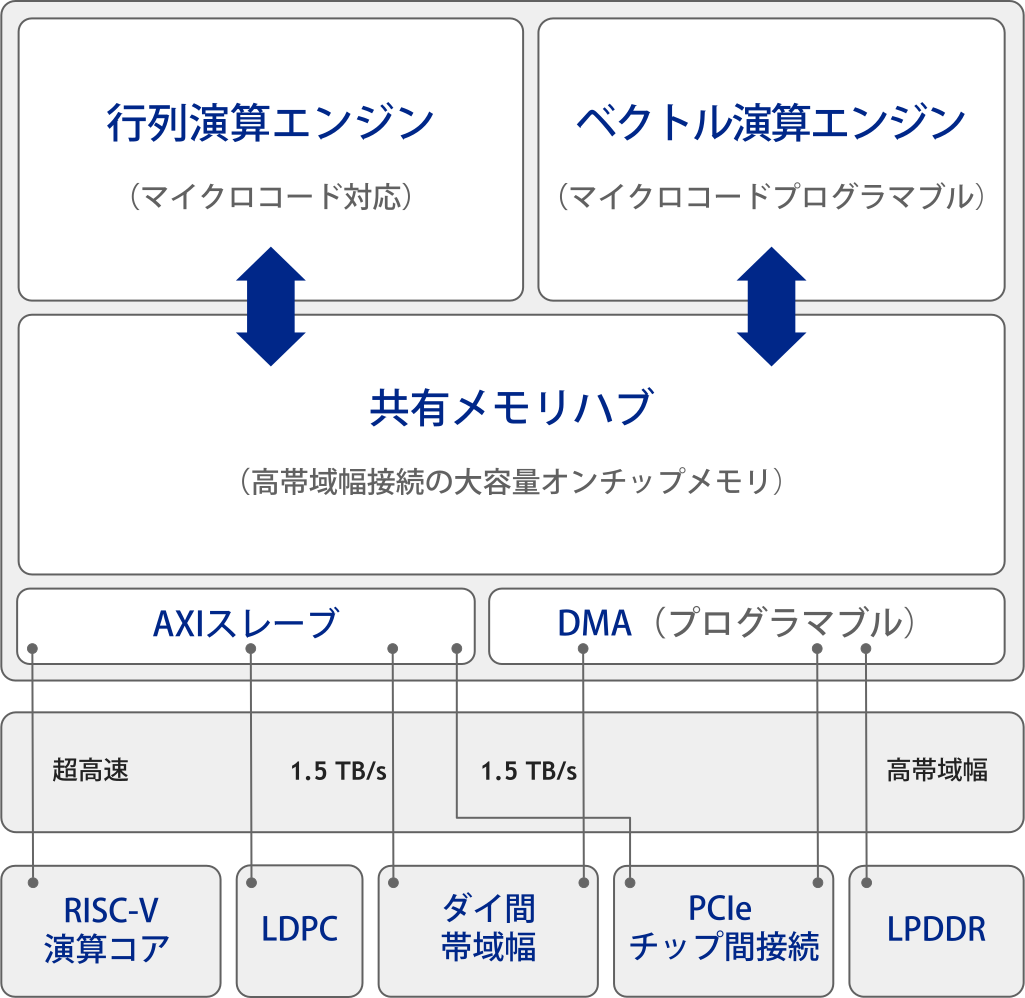
RAIDEN™は、ワークロード全体を実行し、システム全体をスケールできるよう設計された、高エネルギー効率のスケーラブルなチップレットプラットフォームです。その中核を担う新開発のDNA-X®アーキテクチャは、前世代の実行時再構成機能を継承しながら、新たにマイクロコードでプログラム可能な行列・ベクトル処理エンジンを搭載。ニューラル推論にとどまらず、進化し続けるテンソル演算、信号処理、不規則な演算処理にも柔軟に対応します。
さらに、パッケージ内蔵の64ビットRISC-Vコアが、DNA-Xと同期する共有メモリアーキテクチャを介して、アプリケーションロジック、検索、オーケストレーション、制御、安全機能を実行します。
RAIDENがスケールするのは、TOPSだけではありません。フィジカルAIを支える実行環境全体を拡張します。ヘテロジニアスコンピュート、メモリ、接続性を一体としてスケールさせ、1~4個のコンピュートダイ、最大256GBのLPDDR5Xメモリ、548GB/sのメモリ帯域幅、1.54TB/sのパッケージ内ダイ間帯域幅、さらに最大800GB/sの双方向チップ間接続に対応します。
1モデルだけでなく、エージェント型AIの処理ループ全体を実行
フィジカルAIは、1つまたは複数のAIモデルを中心に、制御フロー、検索、センサー処理など、複数の不規則かつレイテンシに敏感な処理が連続するループです。RISC-Vアプリケーションコアと、DNA-Xのプログラマブルな行列・ベクトル処理エンジンが連携することで、さまざまなワークロードにわたり予測可能で安定した性能を提供します。
2AIの進化に、RAIDENも適応
マイクロコードでプログラム可能なDNA-Xエンジン、RISC-Vコア、専用LDPCアクセラレータにより、AIと非AIの演算処理を1つのヘテロジニアスプラットフォームに統合。DNA-Xは、マイクロコードによって新たな演算子やモデルアーキテクチャに適応できるため、AI技術の進化に応じてRAIDENは最適化された実行環境を維持できます。
31チップの限界を超えて、さらにスケール
RAIDENは、最大1.5TB/sのUCIeファブリックで1~4個のコンピュートダイを統合し、さらに最大800GB/sのチップ間接続に対応します。 これにより、レチクルサイズの制約を受けるモノリシックチップの限界を超え、オンボードの自律システムからエッジデータセンターまで、1つのアーキテクチャで柔軟にスケールできます。オンボードの自律システムからエッジデータセンターまで、1つのアーキテクチャと統合環境で幅広い展開に対応します。
4既存のモデルを、そのまま活用
MERA™ソフトウェアは、現在SAKURA-IIですでに実運用されており、Hugging Face、ONNX、ExecuTorch、TensorFlow Liteにネイティブ対応。x86、Arm、RISC-Vホストもサポートしています。MERA 3.0では、RAIDEN向けにソフトウェア機能をさらに拡張。新しいシリコンでも、ツールチェーンはそのまま。
フィジカルAIプラットフォームでは、ワークロードが利用可能なメモリ容量を超えた場合、メモリ帯域幅がコンピュートへのデータ供給に追いつかない場合、あるいは複数のダイ間で十分な速度のデータ交換ができない場合、システム全体の処理性能が低下します。RAIDENは、この3つの課題すべてに対応するよう設計されています。
最大256GBのLPDDR5Xにより、大規模なマルチモーダルモデルとそれを支えるパイプラインをメモリに保持させ、548GB/sのメモリ帯域幅でコンピュートへ継続的にデータを供給します。
さらに、最大1.54TB/sのダイ間帯域幅により、4つのDNA-XとRISC-Vプロセッサコアが1つの統合システムとして動作し、共通のコンピュート・メモリファブリックを介してオンチップSRAMも共有します。これにより、スワップ、パーティショニング、過度な量子化を抑え、複数の独立したアクセラレータを組み合わせるのではなく、緊密に統合された1つのヘテロジニアスコンピュートプラットフォーム上で、フィジカル AIのワークロード全体を実行できます。
インテリジェントマシンからエッジデータセンターまで幅広くスケールし、設定可能な電力プロファイルによって、さまざまな性能要件や導入環境にも柔軟に対応します。
* 2:4構造スパースに対応したFP4スパース演算をサポート。INT4、FP4、INT8、FP8、FP16、BF16、FP32をネイティブにサポートし、混合精度演算にも対応します。MXFP8、MXFP4、NVFP4と互換性があり、マイクロコードによって新たなAI演算子にも対応可能です。** プログラマブルなマイクロコードによってDSPライクな機能を提供し、非AIワークロードや計算負荷の高い数学演算にも対応します。*** RISC-VアプリケーションコアはLinuxに対応し、単独で、または他のヘテロジニアスコンピュートコアと組み合わせて、フル機能のOSを実行できます。
フィジカルAIは、ロボットのオンボードコンピュート、工場の検査ライン、オンプレミスの推論ノードなど、さまざまな環境で活用されます。そこに共通するのは、単純なピークTOPSだけでは性能を測れないワークロードです。大規模なマルチモーダルモデル、リアルタイムのセンサーストリーム、複数の処理が並行して動作するパイプラインでは、データ移動そのものがボトルネックになります。
RAIDENなら、インテリジェントマシンからエッジデータセンターまで、1つのアーキテクチャで幅広いフィジカル AI環境をカバーできます。
アーリーアクセスパートナーには、2027年第1四半期に予定されているサンプル提供開始時に、カスタマーサンプルの優先提供対象として検討される機会が提供されます。量産開始は2027年下半期を予定しています。
本プログラムへの参加枠には限りがあり、アプリケーションとの適合性に基づいて参加企業を選定します